0先看全貌:两条流水线
图像压缩的通用套路叫"变换编码":换个角度描述图像 → 有选择地丢精度 → 把结果紧凑地写成比特。下面两条流水线一一对应,有损标出的是"真正丢信息"的步骤,其余步骤都是可逆的。
1色彩转换:把"亮度"和"颜色"拆开
传感器给出的是每个像素的 R、G、B 三个数。第一步把它换成 Y(亮度) + Cb(偏蓝程度) + Cr(偏红程度)。JPEG(JFIF 规范,沿用 BT.601 系数)的公式是:
Cb = 128 − 0.1687·R − 0.3313·G + 0.5·B
Cr = 128 + 0.5·R − 0.4187·G − 0.0813·B HEVC 常用 BT.709 系数:Y = 0.2126R + 0.7152G + 0.0722B;思路完全一样,只是对应的显示器原色不同
| 符号 | 含义 |
|---|---|
| R, G, B | 像素的红、绿、蓝值,8 位时范围 0–255 |
| 0.299 / 0.587 / 0.114 | 人眼对三种颜色亮度的敏感权重:对绿最敏感、对蓝最不敏感。三者加起来正好 = 1,所以纯白 (255,255,255) 算出来 Y = 255,不会溢出 |
| Cb, Cr | "蓝色减去亮度"和"红色减去亮度"的缩放版。+128 是把可能为负的值平移到 0–255 区间 |
验证一下:纯灰色 R=G=B=100 → Y = 100×(0.299+0.587+0.114) = 100;Cb = 128 + 100×(−0.1687−0.3313+0.5) = 128 + 0 = 128;Cr 同理 = 128。灰色没有颜色,色差正好落在"零点" 128 ✔。
为什么要拆?——人眼对颜色细节"近视"
视网膜上感知亮度的视杆+视锥分布密,分辨颜色的能力却粗得多。所以可以只保留全分辨率的 Y,把 Cb/Cr 的分辨率降一半甚至四分之一,人基本看不出——这就是色度子采样,也是两种格式第一处"有损"。
2DCT:把像素换成"频率"来描述
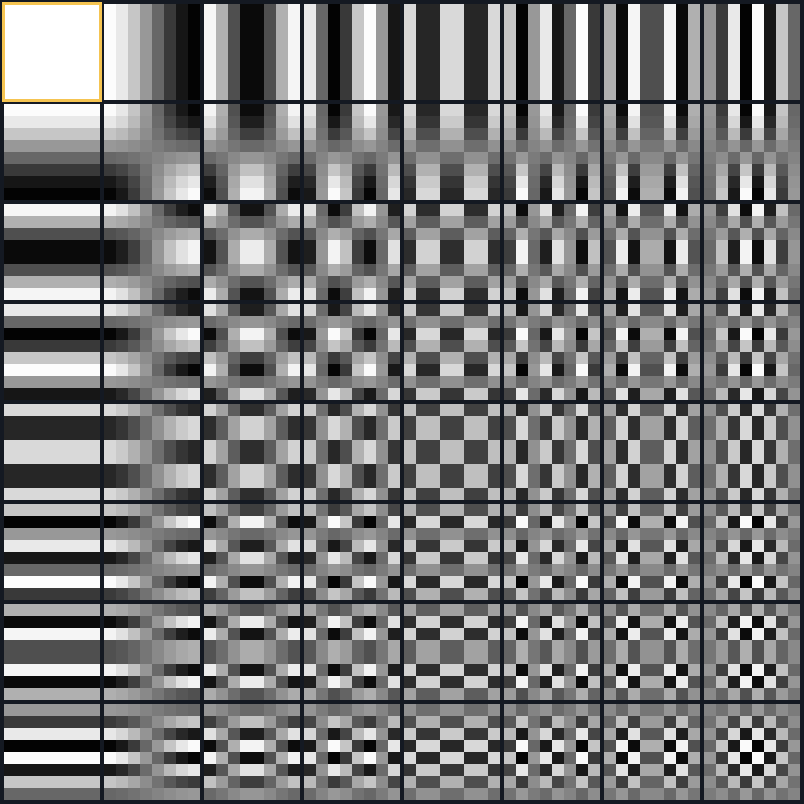
这是整个图像压缩最核心的一步。JPEG 把亮度图切成一个个 8×8 的小块,每块 64 个像素,然后做二维离散余弦变换(DCT-II):
| 符号 | 含义 |
|---|---|
| f(x,y) | 8×8 块里第 x 列、第 y 行像素的亮度值(已减 128) |
| u, v | 频率编号 0–7。u 是横向频率、v 是纵向频率。u=v=0 表示"完全不变化" |
| F(u,v) | "这个块里含有多少 (u,v) 这种花纹"——共 64 个系数,和原来 64 个像素一一等价 |
| cos[(2x+1)uπ/16] | 一条在 8 个像素上走 u/2 个周期的余弦波。(2x+1) 而不是 2x,是因为采样点取在每个像素的中心(半像素偏移) |
| C(u), 1/4 | 归一化系数,保证变换"能量守恒"(正交),可以原样逆变换回来 |
直观理解:像音乐的"频谱"
一段声音可以分解成低音、中音、高音;一块图像也可以分解成"平缓变化"(低频)和"细碎纹理"(高频)。DCT 本身一点信息都不丢(可以完全逆变换),但它有一个神奇特性——能量集中:自然照片里大部分块都很平滑,能量几乎全集中在左上角几个低频系数,其余系数接近 0。
代入真实数字:一块蓝天
取一块平滑的天空,亮度从左上 150 渐变到右下 174(每往右 +2,每往下 +1.5)。我用上面的公式实际算了一遍:
验算 DC 系数:块平均亮度 = 150 + 2×3.5 + 1.5×3.5 = 162.25,减 128 得 34.25。代入公式 u=v=0:F(0,0) = ¼ × ½ × (64 × 34.25) = 274 ✔,和程序算的一样。也就是说 DC = 8 × 平均值。
3量化:唯一"主动丢信息"的地方
DCT 之后,JPEG 用一张 8×8 的量化表 Q(u,v),把每个系数除以对应的数再四舍五入:
这张表为什么长这样?
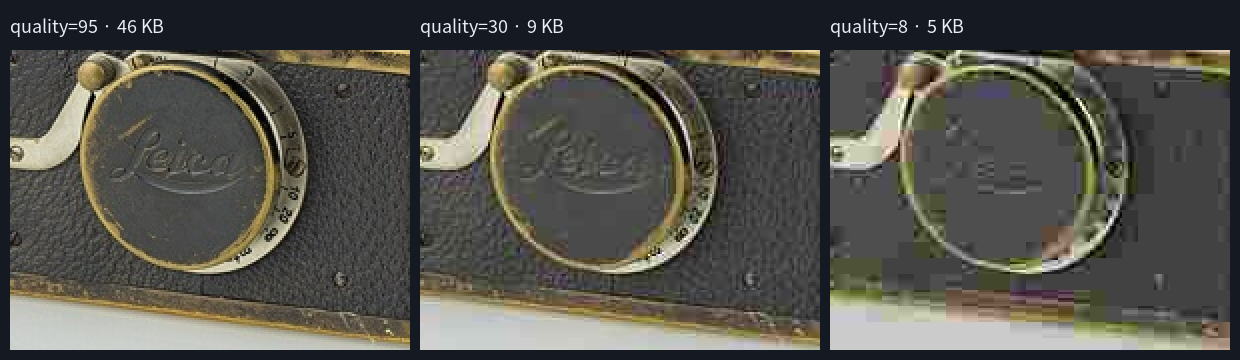
左上角数字小(低频保留精细),右下角数字大(高频粗暴舍弃)。这是 JPEG 委员会做心理视觉实验得出的:人眼对大面积明暗变化敏感,对细碎纹理的精确强度不敏感。
你在软件里拖的"质量 1–100"就是给这张表整体乘一个系数(libjpeg 实现):
S = 5000/q (q<50);S = 200 − 2q (q≥50)
Q′ = ⌊(Q·S + 50) / 100⌋
例:质量 90 → S = 20 → 左上角 16 变成 ⌊(16×20+50)/100⌋ = 3。
继续代入刚才那块蓝天
| 系数 | 原值 F | 质量 50:÷Q | 存下来 | 质量 90:÷Q | 存下来 |
|---|---|---|---|---|---|
| DC (0,0) | 274.0 | ÷16 = 17.1 | 17 | ÷3 = 91.3 | 91 |
| (1,0) 横向渐变 | −36.4 | ÷11 = −3.3 | −3 | ÷2 = −18.2 | −18 |
| (0,1) 纵向渐变 | −26.6 | ÷12 = −2.2 | −2 | ÷2 = −13.3 | −13 |
| 其余 61 个 | 0 | 0 | 0 | 0 | 0 |
解码还原后,质量 50 的最大像素误差是 2(第一行从 150 变成 152),质量 90 是 1——在 0–255 里肉眼完全看不出。64 个像素最后只需要存 3 个小整数,这就是压缩的来源。
4熵编码:把一串小整数写成最短的比特
① Zigzag 之字形扫描
把 8×8 系数按"之"字形从左上扫到右下,排成 64 个数的一维序列。因为非零值都在左上,扫出来是 [17, −3, −2, 0, 0, 0, …, 0]:前面几个有值,后面一长串 0。
② DC 差分 + AC 游程编码
- DC 差分(DPCM):相邻块的平均亮度很接近,所以存 ΔDC = DC当前 − DC前一块,通常是个很小的数。
- AC 游程编码:每个非零 AC 系数记成"(前面有几个 0,这个数要几位)+ 数值"。一长串尾巴 0 直接用一个 EOB(块结束)符号代替——刚才那 61 个 0 只占几个比特。
③ 哈夫曼编码:常见的符号用短码
像摩尔斯电码一样,出现概率高的符号给短码,概率低的给长码。理论极限是香农熵:
5HEIF 是"盒子",HEVC 才是"压缩算法"
很多人以为 HEIF 是一种压缩算法,其实它是 MPEG 在 2015 年定的容器格式(ISO/IEC 23008-12),基于 MP4 同一套"盒子"(ISOBMFF)结构。真正压缩图像的是装在里面的 HEVC(H.265)码流——就是 4K 视频用的编码器,把照片当成视频里的一帧关键帧(I 帧)来压。
📦 盒子里装什么
主图像(HEVC 码流)、缩略图、EXIF 拍摄参数、色彩描述(colr:色域、伽马曲线)、尺寸(ispe)、解码器配置(hvcC)。
🧩 大图切片拼接
HEVC 单帧有尺寸限制,大图常被切成若干小图块分别编码,再用 grid 描述拼回去,解码时可并行。
🔌 也能装别的
同一个容器还能装 AV1(就是 AVIF)、深度图、HDR 增益图、连拍序列。iPhone 的 .HEIC 就是"HEIF + HEVC"。
下面 ⑥–⑩ 讲的是 HEVC 比 JPEG 强在哪。可以对照第 ⓪ 节的流水线看。
6自适应分块 + 率失真优化:该粗的地方粗,该细的地方细
JPEG 不管画面内容,一律切成 8×8。HEVC 先切成 64×64 的编码树单元(CTU),再用四叉树递归往下切:每一块都可以选择"不切"或"切成 4 个一半大小的子块",最小到 8×8(变换块还能到 4×4)。
| 符号 | 含义 |
|---|---|
| D(Distortion) | 失真:压缩后和原图的差别,通常用误差平方和 ∑(原像素 − 重建像素)² |
| R(Rate) | 码率:这种切法 + 这些系数一共要花多少比特 |
| λ(拉格朗日乘子) | "1 比特值多少画质"的汇率。λ 大 = 更看重省空间。参考编码器 HM 用经验式 λ ≈ 0.57 × 2(QP−12)/3,和下面的量化参数 QP 绑定 |
这本质上是一个带约束的最优化问题:"在给定文件大小下让失真最小",用拉格朗日乘子法转成无约束的 min J。JPEG 完全没有这一层决策,所以平滑区域浪费比特、细节区域又不够用。
7帧内预测:先"猜",只存猜错的部分
这是 HEVC 比 JPEG 省空间最关键的一招。编码每个块之前,先用它上方和左方已经解码好的像素去预测这个块长什么样,然后只编码残差:
HEVC 提供 35 种预测模式:
模式 0:Planar(平面)
用上边和左边的像素做双线性插值,适合平滑渐变——蓝天、皮肤、虚化背景。
模式 1:DC(平均)
整块都预测成"上邻+左邻的平均值",适合纯色区域。
模式 2–34:33 种角度
沿某个方向"延伸"边上的像素,适合有方向的纹理:电线、雪山棱线、栏杆。
Planar 模式的公式(N×N 块)
拆开看:前两项是"左边像素 L(y) 和右上角 T(N) 按横向距离加权"——横向线性插值;后两项是"上边像素 T(x) 和左下角 L(N) 按纵向距离加权"——纵向线性插值;两者相加再除以 2N 就是平均。+N 是为了四舍五入。
代入那块蓝天:它本身就是一个完美的线性渐变(横向 +2、纵向 +1.5),Planar 插值几乎能把它完全猜中,残差接近 0——JPEG 要存 3 个系数,HEVC 可能连 1 个系数都不用存。
角度模式:1/32 像素精度的插值
8整数变换 + QP 量化
① 用整数近似 DCT,并且尺寸可变
HEVC 的变换块可以是 4×4、8×8、16×16、32×32。大块适合平滑区(一个 DC 管一大片),小块适合细节。并且它用整数矩阵近似 DCT,避免浮点误差,保证所有解码器算出完全一样的结果。4×4 的整数 DCT 矩阵:
验证第 2 行:浮点 DCT 这一行是 cos(π/8) ≈ 0.924 和 cos(3π/8) ≈ 0.383,比值 0.383/0.924 = 0.414;整数矩阵 36/83 = 0.434,非常接近 ✔。整体放大了约 64×√4 = 128 倍以便用整数运算。
为什么 4×4 帧内残差改用 DST(离散正弦变换)? 帧内预测是从块的上/左边沿往里推的,离参考像素越远猜得越不准,所以残差呈现"靠边小、往里越来越大"的规律。DST 的第一个基函数 sin(π(2j+1)/9) 恰好就是"从小到大"的形状,比 DCT(第一个基函数是平的)更贴合,压缩效率更高。
② QP 量化参数:每 +6 步长翻倍
| QP | 步长 Qstep | 含义 |
|---|---|---|
| 22 | 218/6 = 2³ = 8 | 高画质 |
| 28 | 224/6 = 2⁴ = 16 | QP 每 +6,步长 ×2,码率约减半 |
| 34 | 230/6 = 2⁵ = 32 | 明显压缩 |
和 JPEG 的"查表"相比,QP 是一个连续的、对数尺度的旋钮;而且 HEVC 编码器可以每个块用不同的 QP(自适应量化),平坦区多保细节防色带、纹理区多压。
9CABAC:突破"每个符号至少 1 比特"的限制
CABAC = 基于上下文的自适应二进制算术编码,分三步:
① 二值化
把所有要编的东西(系数大小、预测模式、是否切块……)都拆成一串 0/1。
② 上下文建模
根据"周围块的情况"估计下一个比特是 1 的概率 p。比如邻块都没切分,这块大概率也不切。概率边编码边更新,自动适应这张图。
③ 算术编码
不给每个符号分配整数长度的码字,而是把整条消息映射成 [0,1) 区间里的一个小数。
算术编码为什么能做到"零点几比特"
从区间 [0, 1) 开始,每编一个比特,就按概率把当前区间切成两段,选中实际出现的那段:
代入数字:某个标志位 95% 的情况都是 0。
| 方法 | 编一个"0"花费 | 平均每个符号 |
|---|---|---|
| 哈夫曼(JPEG) | 至少 1 比特 | 1 比特 |
| 算术编码(HEVC) | −log20.95 ≈ 0.074 比特 | 熵 H = −0.95·log20.95 − 0.05·log20.05 ≈ 0.286 比特 |
同样的信息,CABAC 只用约 29% 的比特。熵编码这一环通常能比哈夫曼再省 10% 以上的码率(视内容而定)。
10环路滤波:把方块和波纹"抹平"
去块滤波(Deblocking)
在块的边界上检查:如果边界两侧都很平滑、只在边界处有一个跳变,那这个跳变多半是压缩造成的假边缘,就把它平滑掉;如果两侧本身纹理很多,说明是真实边缘,就不动。
判断:d = |p₂ − 2p₁ + p₀| + |q₂ − 2q₁ + q₀| < β(QP)
p、q 是边界两侧的像素;|p₂−2p₁+p₀| 是二阶差分,衡量"弯曲程度",越小越平坦。阈值 β 随 QP 增大——压得越狠,越积极地去块。
SAO 样点自适应偏移
量化会在锐利边缘附近产生振铃(一圈一圈的波纹)。SAO 把像素分类后加一个小偏移量来纠正:
• 边缘偏移:和两个邻居比较,判断自己是"谷底 / 凹角 / 凸角 / 峰顶",谷底往上补、峰顶往下压;
• 带偏移:把亮度分成 32 段,对其中连续 4 段整体加偏移,修正大面积的亮度漂移。
偏移量由编码器算好写进码流,解码器照做。
JPEG 没有这一步,所以压狠了会看到方块和边缘毛刺(见第 ③ 节的图)。
1110 位为什么让天空更顺:把色带的数学算清楚
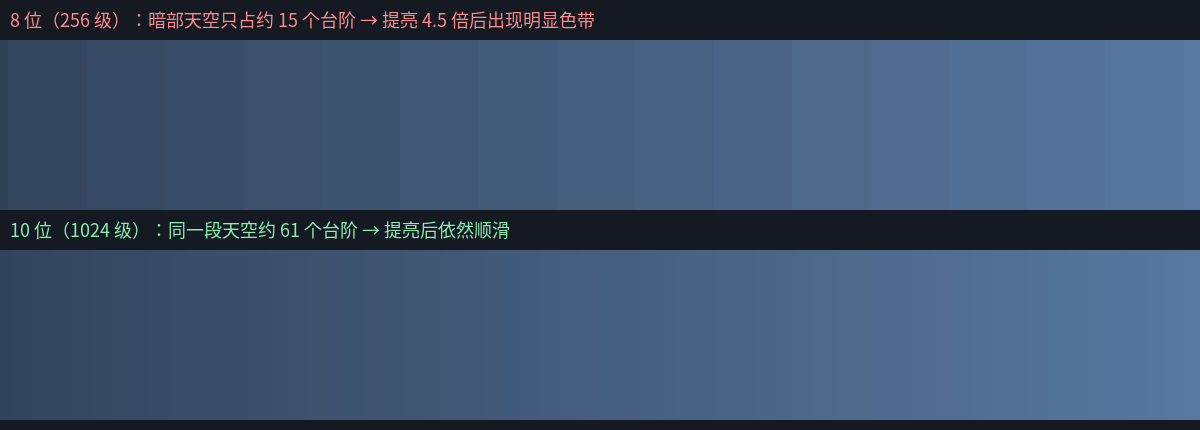
代入真实场景:夜晚的天空很暗,假设亮度只在满量程的 8%–14% 之间缓慢渐变(跨度 6%)。
| 位深 | 这段天空能用的台阶数 | 相机横向约 7000 像素,每个台阶宽 | 后期提亮 4.5 倍后,每级跳变 |
|---|---|---|---|
| 8 位 | 0.06 × 255 ≈ 15 级 | ≈ 470 像素一条 | 每级跳 4.5 个码值 → 明显色带 |
| 10 位 | 0.06 × 10²³ ≈ 61 级 | ≈ 115 像素一条 | 折合 8 位显示约 1.1 个码值 → 看不出 |
12附:HLG 曲线到底"混合"了什么
HLG(Hybrid Log-Gamma,BT.2100)不是压缩算法,而是一条把场景亮度映射成信号值的曲线(OETF)。它是分段函数:
E′ = a · ln(12E − b) + c 1/12 < E ≤ 1 a = 0.17883277,b = 1 − 4a = 0.28466892,c = 0.5 − a·ln(4a) = 0.55991073;E = 归一化的场景线性亮度,E′ = 信号值
| 部分 | 含义 |
|---|---|
| √(3E)(暗部) | 平方根曲线,和传统 SDR 伽马(≈ E0.45)几乎一样 → 普通屏幕也能大致正常显示暗部和中间调,这就是"兼容" |
| a·ln(…)(亮部) | 对数曲线,把很亮的高光(太阳、雪山反光)压缩进剩下一半的信号里 → HDR 屏幕能把它们还原得更亮 |
验证两段在分界点无缝衔接:E = 1/12 时,第一段 √(3/12) = √0.25 = 0.5;第二段 a·ln(1 − b) + c = a·ln(4a) + 0.5 − a·ln(4a) = 0.5 ✔(常数 b、c 就是为此反推出来的)。
验证最大值:E = 1 时,a·ln(12 − 0.28467) + c = 0.17883 × ln(11.7153) + 0.55991 = 0.17883 × 2.4610 + 0.55991 ≈ 1.000 ✔。
所以在普通屏幕上看 HLG 照片会发灰:亮部被对数压扁了,普通屏幕又不会按 HDR 方式把它们"展开"。这就是之前建议你不开 HLG 的数学原因。
13总结:HEIF 到底比 JPEG 好在哪
| 环节 | JPEG(1992) | HEIF / HEVC 帧内(2013) | 效果 |
|---|---|---|---|
| 分块 | 固定 8×8 | 64×64 四叉树自适应,最小 4×4 | 平滑区省比特,细节区保细节 |
| 预测 | 无(只有 DC 差分) | 35 种帧内预测,只编残差 | 最大的增益来源 |
| 变换 | 8×8 浮点 DCT | 4–32 整数 DCT + 4×4 DST | 大块更好集中能量 |
| 量化 | 固定查表 | QP 连续可调,可逐块自适应 + RDO | 码率分配更聪明 |
| 熵编码 | 固定哈夫曼,≥1 比特/符号 | CABAC 自适应算术编码 | 再省 10% 以上 |
| 后处理 | 无 | 去块 + SAO | 压缩伪影更少 |
| 位深 | 8 位 | 8/10 位(相机常用 10 位) | 渐变更顺、可调空间更大 |
| 编解码速度 | 非常快、非常省电 | 计算量大得多(靠相机/手机硬件加速) | JPEG 胜 |
| 兼容性 / 授权 | 所有设备都支持,免授权费 | HEVC 有专利授权费 → 部分 Windows/网页/老软件默认不支持 | JPEG 胜 |
综合起来,学术和工业测试普遍报告:同样主观画质下,HEVC 帧内编码比 JPEG 节省约 40%–50% 码率(这是经验范围,具体随图像内容和编码器设置浮动)。这就是你在相机上看到"HEIF 更小、渐变更顺"的原因。
前沿演进:之后还有什么
AVIF
同样用 HEIF 容器,里面换成免授权费的 AV1 编码。浏览器支持好,网页图片在普及。
JPEG XL
JPEG 委员会的新一代:可变尺寸 DCT、XYB 感知色彩空间、ANS 熵编码,还能把老 JPEG 无损重新压缩小约 20%。苹果已在部分新系统里加入支持。
VVC / H.266
HEVC 的继任者(2020),帧内模式扩展到 67 种、块更灵活,压缩率再提升,但编码更复杂、硬件尚未普及到相机。