0先用三句话记住三种格式
📷 JPEG(1992 年)
"丢掉眼睛看不出的细节"。有损压缩,照片变小 5–10 倍,所有设备都能打开。
🎬 HEIF(2015 年)
"用拍视频的技术压照片"。也是有损,但更聪明:先猜,只记猜错的部分。同样画质比 JPEG 小约一半。
🖼️ PNG(1996 年)
"一个像素都不丢"。无损压缩,解压后和原图一模一样。适合截图、文字、图标、透明背景;存照片会很大。
1先搞懂:省空间只有两条路
无损路线一:换个更短的写法
信息一点不丢,只是写得更紧凑。比如把 "2 2 2 2 2 2 2" 写成 "2 重复 7 次"。能还原得一模一样。
👉 PNG 只走这条路。JPEG 和 HEIF 的最后一步也用它。
有损路线二:扔掉不重要的
把人眼不敏感的信息直接扔掉,再也找不回来。但扔得巧,人根本看不出来。
👉 JPEG 和 HEIF 主要靠这条路,所以才能压得那么小。
2JPEG 第 1 步:把"亮"和"颜色"分开,颜色存少一点
人眼有个特点:对明暗很敏感,对颜色的细节很迟钝。所以 JPEG 先把每个像素的"红绿蓝"换成"亮度 + 两个颜色值",然后颜色只存一部分。
换算公式(只看第一行就够)
0.299 × 100 = 29.90.587 × 150 = 88.050.114 × 220 = 25.0829.9 + 88.05 + 25.08 = 143.03 → 亮度 Y ≈ 143(满分 255,中等偏亮)颜色怎么"存少一点":色度子采样
亮度每个像素都存。颜色则几个像素共用一份:
4 × 3 = 12 个数4 + 2 = 6 个数6 ÷ 12 = 50% 一下子少了一半,眼睛却几乎看不出来有损这是 JPEG 第一次丢信息。
3JPEG 第 2 步:DCT——把"一格一格的像素"改写成"渐变 + 花纹"
JPEG 把整张图切成很多 8×8 的小方块,一块一块处理。这一步叫 DCT(离散余弦变换),名字吓人,意思其实很简单:换一种说法描述同一块图。
它把方块拆成"标准花纹"的组合
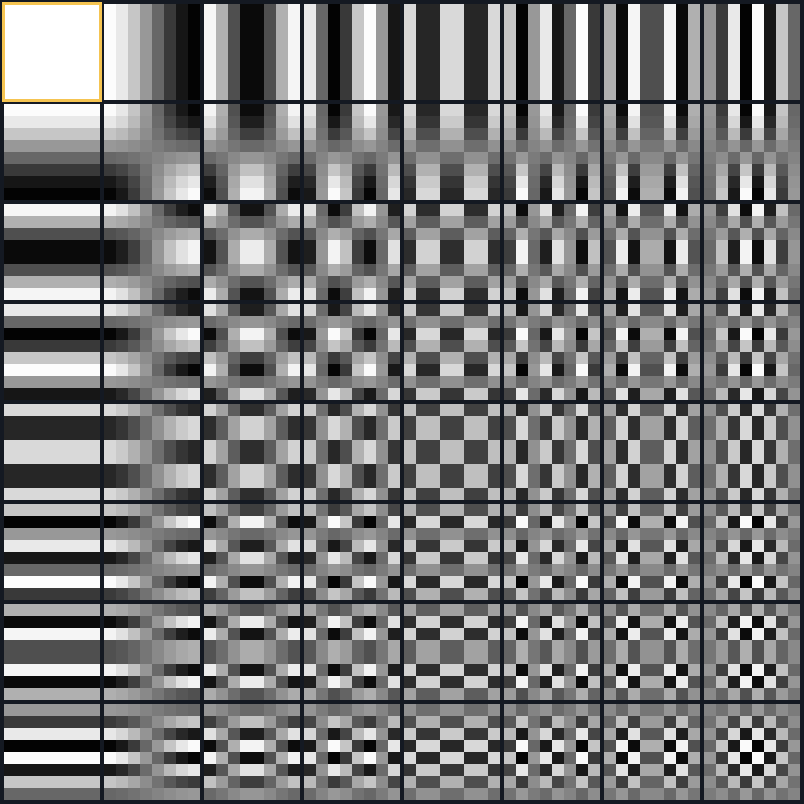
一步一步算:一排 8 个天空像素
为了好算,我们只看方块里的一排(真正的 JPEG 是横竖各算一次,道理完全一样)。这排天空从左到右慢慢变亮:
22 24 26 28 30 32 34 36
22+24+26+28+30+32+34+36 = 2321/√8 ≈ 0.354(这个系数让正算和反算对称,记住"固定"就行):232 × 0.354 ≈ 82.00.98 0.83 0.56 0.20 −0.20 −0.56 −0.83 −0.98
22×0.98=21.6 24×0.83=20.0 26×0.56=14.4 28×0.20=5.5
30×(−0.20)=−5.9 32×(−0.56)=−17.8 34×(−0.83)=−28.3 36×(−0.98)=−35.3
21.6+20.0+14.4+5.5−5.9−17.8−28.3−35.3 ≈ −25.8√(2/8) = 0.5:−25.8 × 0.5 ≈ −12.9。负号的意思是"和花纹方向相反"——花纹是左亮右暗,我们的天空是左暗右亮 ✔DCT 之后,这排 8 个数变成了:
原来 8 个数都很大,现在只剩前 2 个比较大,后面都接近 0。信息还是那些信息,但"重点"全挤到前面了。
4JPEG 第 3 步:量化——把数字"约个大概"
这一步是 JPEG 真正"丢东西"的地方:每个数除以一个"步长",然后四舍五入成整数。
聪明在哪:粗花纹约得细,细花纹约得粗
JPEG 有一张事先定好的步长表。人眼对"大面积明暗"敏感,所以这些花纹步长小(约得细);对"细碎纹理"不敏感,所以步长大(约得粗,常常直接变 0)。比如标准表第一行是:
82.0 ÷ 16 = 5.13 → 四舍五入 → 5−12.9 ÷ 11 = −1.17 → 四舍五入 → −1−1.4 ÷ 16 = −0.09 → 0;其余也全都变成 05 × 16 = 80,−1 × 11 = −11(原来是 82.0 和 −12.9,有点误差,这就是丢掉的部分)每个像素最多差 2(满分 255),也就是不到 1%。人眼完全分辨不出来,但要存的数从 8 个大数变成了"5、−1 和一串 0"。
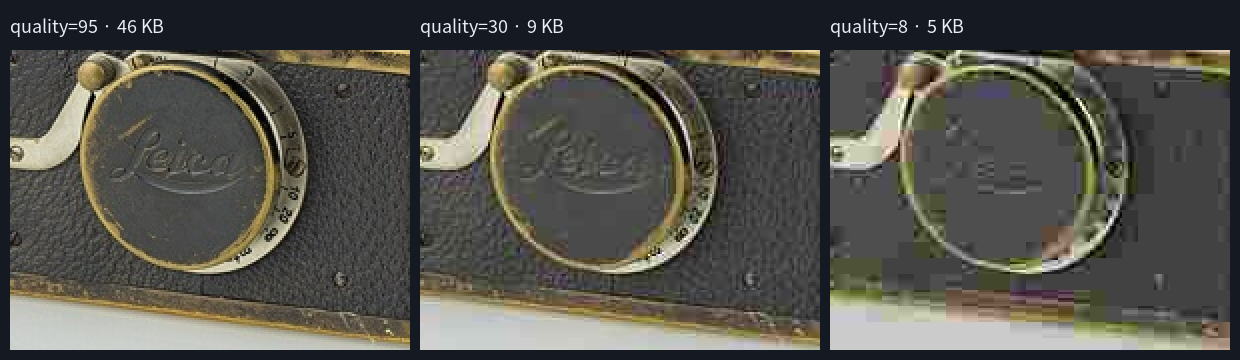
有损这是 JPEG 第二次(也是最主要的一次)丢信息。
5JPEG 第 4 步:把数字写得更短(无损)
现在每个方块剩下一串"几个小数字 + 一大堆 0"。最后一步是把它们写成尽量短的 0 和 1。无损
① 一大串 0,用一个"结束"记号代替
按"之字形"从左上(粗花纹)读到右下(细花纹),读出来是 5, −1, 0, 0, 0, 0, …。后面那一长串 0 不用一个个写,直接写一个"本块结束"记号。
② 常见的写短,少见的写长:哈夫曼编码
10 × 2 = 20 位5×1 + 3×2 + 1×3 + 1×3 = 5 + 6 + 3 + 3 = 17 位(20 − 17) ÷ 20 = 15% 而且一个信息都没丢 ✔6HEIF:用拍视频的技术压照片,四个"更聪明"
先澄清一点:HEIF 只是一个"文件盒子",盒子里装着照片、缩略图、拍摄参数等。真正负责压缩的是盒子里的 HEVC(也叫 H.265)——就是手机拍 4K 视频用的那套技术。它把你的照片当成"视频里的一帧"来压。
大流程和 JPEG 一样(分亮度颜色 → 切块 → 变换 → 量化 → 写短),但每一步都升级了:
聪明 ①:先"猜",只记猜错的部分(最重要的一招)
JPEG 的每个方块都是从零开始描述,完全不看邻居。但照片里相邻的地方往往很像(天空挨着天空,墙挨着墙),HEIF 就利用了这一点。它有 35 种猜法:
平均猜法
"这块大概和上边、左边的平均颜色一样"——适合纯色区域。
平滑猜法(Planar)
"从上边过渡到左边,像渐变一样"——适合天空、皮肤、虚化背景。
33 种方向猜法
"沿着这个方向延续下去"——适合电线杆、雪山棱线、栏杆这种有方向的线条。
聪明 ②:方块大小随画面变
这个"汇率"表示"多花 1 位空间值多少画质"。用户选高画质,汇率就低(舍得花空间);选高压缩,汇率就高(能省则省)。JPEG 没有这种"试一试再决定"的过程。
聪明 ③:写短的方法更好——能做到"一个符号不到 1 位"
10 × 1 = 10 位1 × 0.9 × 0.9 × … (9 次)≈ 0.387;再来 1 个"开":0.387 × 0.1 ≈ 0.0387log₂(1 ÷ 0.0387) ≈ 4.7 位(每多 1 位,能分辨的精度翻一倍:2⁴ = 16,2⁵ = 32,1÷0.0387 ≈ 26 落在中间)聪明 ④:自带"磨皮"——把方块边缘抹平
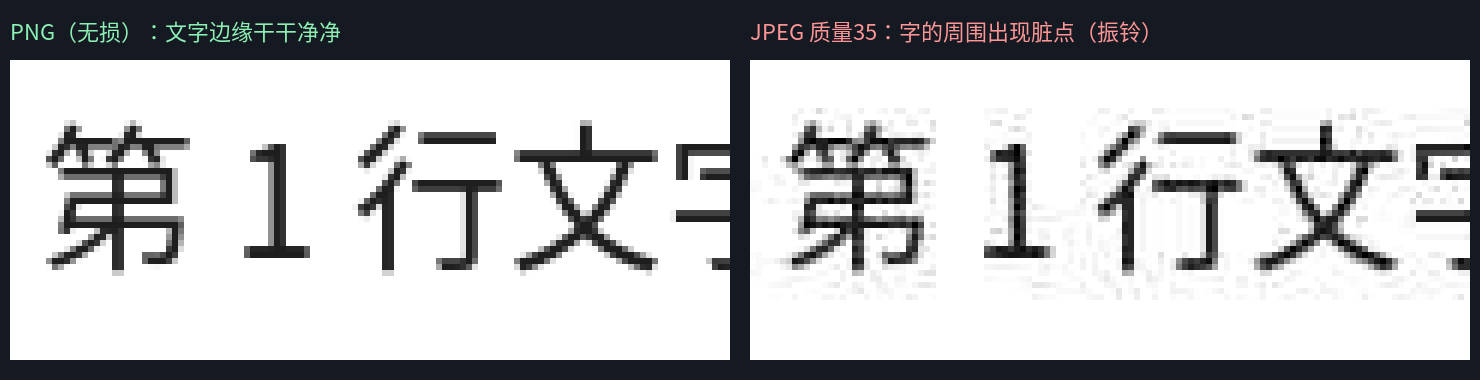
JPEG 压狠了会出现方块和字边脏点(见第 4 节的图)。HEIF 在解压时会自动检查每个方块的边缘:如果两边都很平滑,只在边界上突然跳一下,那多半是压缩造成的"假边",就把它抹平;如果本来就是物体轮廓,就保留不动。另外还会修正锐利边缘旁边一圈一圈的"波纹"。
7PNG:一个像素都不丢的压缩
PNG 在 1996 年诞生,本来是为了替代当时有专利问题的 GIF。它的原则是:解压后必须和原图一模一样,一位都不能差。所以它不能"扔东西",只能想办法写得更短。
它分两步:① 过滤(把像素改写成"差值")→ ② DEFLATE 压缩(找重复 + 哈夫曼)。这两步都可以原样还原。
第 ① 步:过滤——记"和旁边差多少",而不是记本身
152 − 150 = 2;第 3 个:154 − 152 = 2;……每一个都是 2PNG 有 5 种过滤方法,每一行可以挑最合适的那种:
| 名字 | 做法 | 适合 |
|---|---|---|
| None 不过滤 | 原样存 | 本来就很杂乱的行 |
| Sub 左差 | 减去左边像素 | 横向渐变(如上例) |
| Up 上差 | 减去上边像素 | 竖向渐变、和上一行很像 |
| Average 平均差 | 减去(左 + 上)÷ 2 | 斜向平滑区域 |
| Paeth 智能猜 | 在左、上、左上三个里挑一个"最可能"的来减 | 大多数复杂图像 |
左 + 上 − 左上 = 152 + 153 − 150 = 155(如果画面是平滑倾斜的,这个估计最准)|155−152| = 3,上 |155−153| = 2,左上 |155−150| = 5第 ② 步:DEFLATE——找重复 + 哈夫曼
找重复(LZ77)
发现一段内容前面出现过,就写成 "往回数 X 个,照抄 Y 个"。
例:150 2 2 2 2 2 2 2 → 150, 2, [往回 1 个, 抄 6 个]。
这和压缩包(.zip)用的是同一套方法。
哈夫曼编码
和 JPEG 第 4 步一样:常见的写短,少见的写长。
那为什么 PNG 存照片会很大?
照片里到处是传感器的细小噪点、树叶草地的杂乱纹理,几乎找不到完全一样的重复,差值也不小。PNG 又不许"约个大概",就压不下去。实测同一张照片:
| 测试图(实测) | PNG | JPEG(质量 90) | 谁小 |
|---|---|---|---|
| 📷 照片:徕卡相机 960×644 | 585 KB | 126 KB | JPEG 小约 4.6 倍 |
| 📱 截图:手机设置页面(文字 + 纯色) | 71 KB | 86 KB | PNG 更小,而且无损 |
PNG 的另外两个特长
🪟 透明背景
PNG 可以给每个像素多存一个"透明度"值(0 = 完全透明,255 = 完全不透明)。抠好的人像、logo、贴纸都靠它。JPEG 做不到透明。
🎨 最高 16 位
PNG 每个颜色可以存 16 位(65536 级),适合专业修图的中间文件。但这样文件会更大。
88 位和 10 位:为什么 HEIF 的天空更顺
2 × 2 × … × 2(8 个 2)= 256 级;10 位:2¹⁰ = 1024 级,正好是 8 位的 4 倍256 × 6% ≈ 15 级;10 位能用的台阶:1024 × 6% ≈ 61 级7000 ÷ 15 ≈ 470 像素,10 位只有 7000 ÷ 61 ≈ 115 像素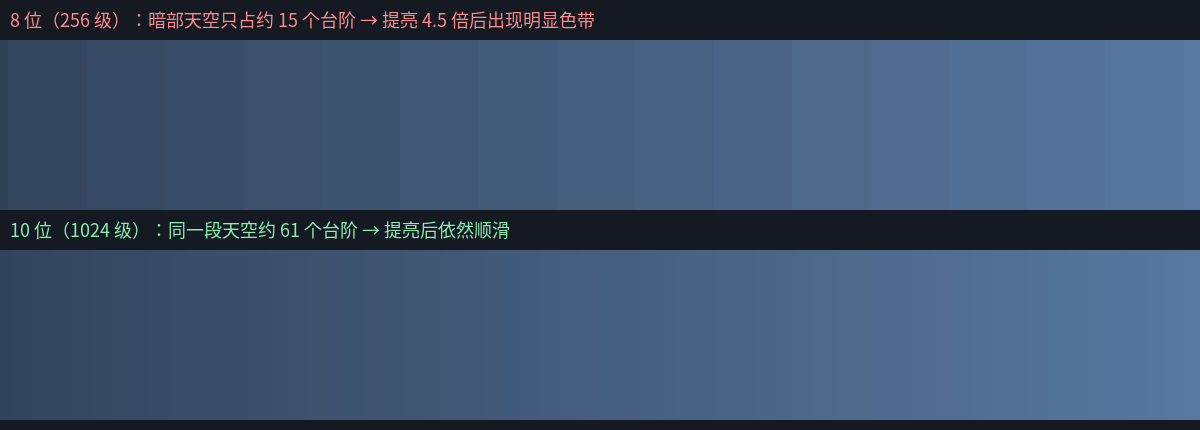
要说清楚的一点:真实照片里有细小噪点,会把台阶"糊"掉一些,所以 8 位 JPEG 不调亮时通常也看不出问题。10 位的好处主要在两种情况:后期调亮或调色,以及大片平滑的渐变(蓝天、夜空、夕阳、虚化背景)。
| 格式 | 位数 |
|---|---|
| JPEG | 只有 8 位 |
| HEIF(你的相机) | 10 位 |
| PNG | 8 位或 16 位 |
9附:HLG 为什么在普通屏幕上发灰
HLG 不是压缩方法,而是一种"怎么分配亮度台阶"的规则,专门为 HDR 屏幕设计。它分两段:
暗部和中间调:和普通照片一样
用的是"开根号"那样的曲线:信号 = √(3 × 亮度)。普通照片也差不多是这么分配的,所以这部分在普通屏幕上看着正常。
高光:被"压扁"存进去
太阳、雪山反光这些特别亮的地方,用对数曲线压缩后存进去。HDR 屏幕会把它们"展开",显示得特别亮;普通屏幕不会展开,就显得灰、平、没精神。
√(3 × 1/12) = √(1/4) = 0.5这就是之前建议你不开 HLG 的原因:你主要在手机和微信里看照片、发照片,开了反而容易发灰。
10总结:三种格式怎么选
| JPEG | HEIF | PNG | |
|---|---|---|---|
| 丢不丢信息 | 有损 | 有损 | 无损,一位不差 |
| 核心方法 | 8×8 块 + DCT + 量化 + 哈夫曼 | 先猜 + 方块大小可变 + 更好的编码 + 自动去方块 | 记差值 + 找重复 + 哈夫曼 |
| 存照片的大小 | 中等 | 最小(约为 JPEG 的一半) | 很大(常是 JPEG 的 4–5 倍) |
| 存截图、文字 | 字边有脏点 | 还可以 | 最好,边缘干净 |
| 色彩位数 | 8 位 | 10 位 | 8 或 16 位 |
| 透明背景 | 不支持 | 支持 | 支持,最常用 |
| 兼容性 | 所有设备都能打开 | 部分电脑、老软件、网页打不开 | 几乎都能打开 |
📷 相机日常拍照
HEIF(你现在的设置)。最小、渐变最顺,iPhone 能直接看。
📤 发给别人原图 / 冲印
JPEG。谁都能打开,冲印店也都收。
🖥️ 截图、文字、图标、抠图
PNG。一个像素不丢,可以透明。